빠른 피드백이 생겨도 지도할 일은 사라지지 않는다
AI 시대 현장지도자는 학습자의 결과물만 보는 사람으로 남아서는 안 된다. 무엇을 근거로 판단했는지, 어떤 정보를 놓쳤는지, 조건이 바뀌면 결론을 수정할 수 있는지 살펴야 한다. 자동으로 답을 얻는 속도가 빨라질수록 사람이 어떤 판단을 배웠는지는 더 의식적으로 확인해야 한다.
현장지도자는 신입이나 직무전환자가 실제 업무를 익히도록 관찰하고 피드백하며, 맡길 수 있는 업무 범위를 판단하는 사람이다. 직책이 관리자일 수도 있고 숙련 실무자나 사내 전문가일 수도 있다. AI 도구를 가장 잘 다루는 사람과 반드시 같지는 않다. 중요한 것은 업무 기준을 설명하고 다른 사람의 판단을 성장시키는 능력이다.
가상의 OJT 장면을 생각해 보자. 신입이 AI의 도움을 받아 고객 제안서를 잘 완성했다. 지도자는 문장을 몇 군데 고친 뒤 통과시킨다. 그런데 다음 고객의 조건이 달라지자 신입은 무엇을 유지하고 무엇을 바꿔야 할지 설명하지 못한다. 첫 결과물의 품질은 괜찮았지만 판단을 배웠는지는 확인하지 않은 것이다.
이 상황에서 AI 사용을 줄이는 것만으로 문제가 해결되지는 않는다. 완성품만 평가하는 지도 방식이 그대로라면 도움의 출처가 동료이든 AI이든 같은 문제가 생긴다. 지도자는 결과가 맞는지에 더해 그 결과에 도달한 이유를 관찰할 수 있는 과제를 만들어야 한다.
기업교육의 과제는 지도자의 일을 모두 자동화하는 데 있지 않다. 반복 연습과 기본 피드백을 지원하면서, 사람의 시간이 필요한 판단을 더 명확하게 남기는 데 있다. 이를 위해서는 연습 도구의 기능과 현장지도자의 책임을 함께 설계해야 한다.
전문직 훈련의 성과를 도구 하나의 효과로 읽지 않는다
2026년 9월 Zhipeng Wu와 Long Li가 발표한 연구는 중국 정저우대학교 제1부속병원의 경력 초기 안과 의사 100명을 대상으로 AI 통합 훈련과 기존 사례 기반 훈련을 비교했다. 두 집단은 각각 50명이며, 모두 12주 동안 48시간의 교육과정을 거쳤다. 배정은 무작위가 아니라 교육과정 등록 순서에 따른 코호트 방식이었다.
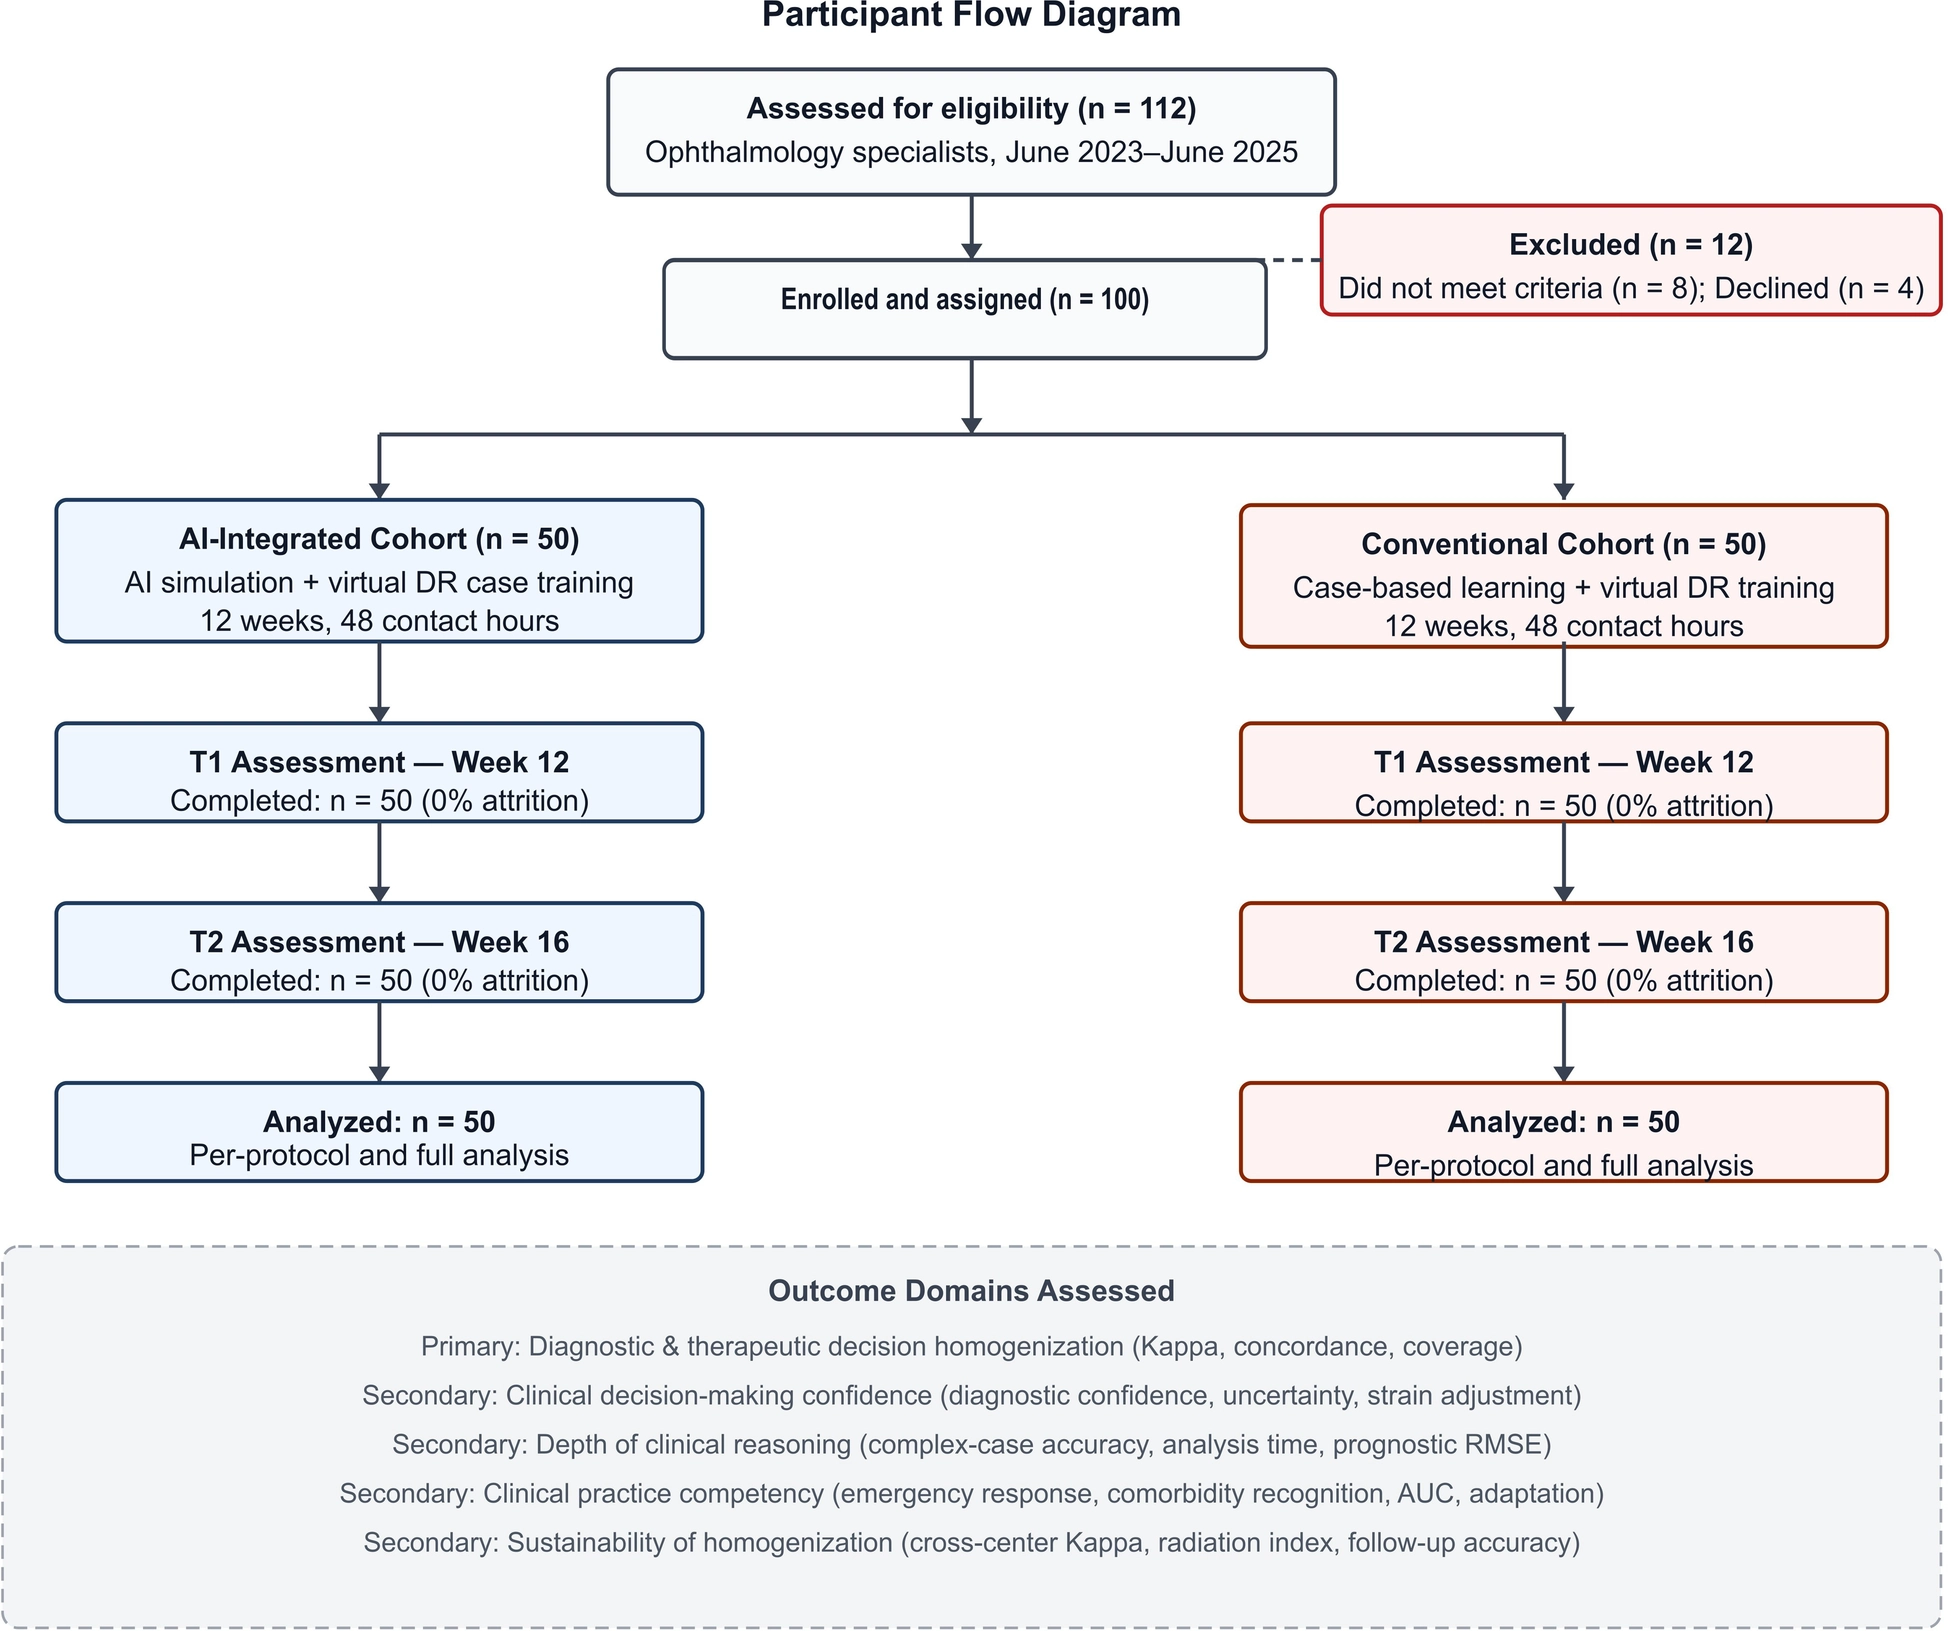
Wu·Li, Figure 1. 단일 기관의 두 코호트와 교육·평가 흐름이다. 무작위 배정 실험이나 일반 기업 직원의 성과 자료로 해석해서는 안 된다.
AI 통합 과정에는 영상 인식, 동적으로 바뀌는 사례, 즉각적인 피드백이 결합돼 있었다. 동시에 숙련 의사의 교육과 전문가 합의 기준도 포함됐다. 따라서 이 연구를 ’AI가 인간 지도자를 대체했다’는 근거로 읽을 수 없다. 비교된 것은 여러 요소를 갖춘 훈련 방식이었다.
기업교육에서도 비슷한 구분이 필요하다. 새 도구를 도입하면서 사례를 정리하고 피드백을 빠르게 하고 지도자 간 기준까지 맞췄다면, 이후 변화는 그 전체 구성과 함께 살펴야 한다. 좋아진 결과를 소프트웨어 하나에만 돌리면 다음 조직에 필요한 운영 조건을 놓치기 쉽다.
이 연구는 AI 통합 집단에서 여러 평가 지표가 더 높았다고 보고하지만, 단일 기관의 비무작위 연구다. 관찰하지 못한 동기나 기술 수용성의 차이를 완전히 배제할 수 없고, 추적 기간도 교육 후 한 달이었다. 실제 환자 결과를 평가한 연구가 아니라는 한계도 있다. 기업교육에 그대로 옮길 효과 크기를 찾기보다 훈련과 평가를 어떻게 연결했는지 살피는 편이 타당하다.
기업의 현장지도자는 이 구성을 자신의 업무에 맞춰 해석할 수 있다. 공통 기준, 반복 연습, 피드백, 사람의 검토가 각각 어디에서 작동하는지 적어 보는 것이다. 도구가 어떤 일을 지원하는지 분명해져야 지도자에게 남는 역할도 구체화된다.
지도자는 답을 보기 전에 학습자의 근거를 듣는다
AI가 만든 답과 피드백이 먼저 제시되면 학습자는 그 설명에 맞춰 자신의 판단을 뒤늦게 구성할 수 있다. 지도자는 매끄러운 설명을 듣고 이해했다고 생각하지만, 실제로는 제시된 문장을 잘 요약했을 수 있다. 그래서 학습자의 최초 판단을 확인할 장치가 필요하다.
기업의 모의 과제라면 학습자가 먼저 선택과 이유를 간단히 남기게 할 수 있다. 무엇을 중요한 정보로 봤는지, 어떤 대안을 검토했는지, 추가로 확인하고 싶은 정보가 무엇인지 적는 방식이다. 긴 사고 과정을 빠짐없이 쓰게 할 필요는 없다. 업무 판단을 검토하는 데 필요한 근거만 드러나면 된다.
그다음 AI의 제안과 비교한다. 결론이 같다면 근거도 같은지 확인하고, 다르다면 어느 조건 때문에 달라졌는지 살핀다. AI와 의견이 다르다는 이유만으로 오답으로 처리하지 않는다. 업무 기준에 비춰 어떤 설명이 타당한지 검토하는 것이 학습이다.
가상의 구매 업무를 예로 들면 단가가 가장 낮은 공급사를 선택했는지뿐 아니라 납기, 품질 확인, 대체 공급 가능성을 어떻게 고려했는지 물을 수 있다. AI의 추천이 맞더라도 학습자가 핵심 조건을 이해하지 못했다면 다음 사례에서 취약해질 수 있다. 반대로 추천과 달라도 실제 제약을 근거로 판단했다면 그 이유를 평가해야 한다.
지도자의 질문은 답을 맞힐 때까지 유도하는 문답이 되지 않게 한다. ‘그 조건이 없었다면 무엇을 바꾸겠는가’, ’지금 확인하지 못한 정보는 무엇인가’처럼 판단의 경계를 확인하는 질문이 더 유용하다. 학습자가 지도자의 기대를 추측하기보다 자기 판단을 설명할 수 있어야 한다.
AI 피드백도 함께 검토해야 할 학습 자료다
미국심리학회가 2026년 9월 공개한 임상 훈련 기사에서는 AI 도구가 연습과 피드백의 기회를 넓히는 동시에, 그럴듯하지만 부적절한 조언을 줄 수 있다는 점을 다뤘다. 지도자는 훈련생이 AI를 어떻게 사용하는지 묻고, 유용한 피드백과 오류를 구분하도록 도울 필요가 있다. 임상 맥락의 논의를 기업의 일반 업무에 그대로 적용할 수는 없지만, 피드백 자체도 검토 대상이라는 관점은 참고할 만하다.
자동 피드백이 자세하다고 정확한 것은 아니다. 업무 범위를 벗어난 기준을 적용했거나, 입력에 없는 사실을 전제로 삼았거나, 현장의 제약을 누락했을 수 있다. 지도자는 모든 문장을 다시 채점하기보다 판단에 영향을 주는 핵심 제안이 어떤 근거를 갖는지 확인하게 한다.
| 학습자가 받은 피드백 | 지도자가 확인할 질문 |
|---|---|
| 결론을 더 단정적으로 쓰라 | 현재 증거가 그 강도를 뒷받침하는가 |
| 다른 선택지를 우선하라 | 어떤 조건을 달리 가정했는가 |
| 누락 정보를 보완하라 | 실제로 필요한 정보이며 확인할 수 있는가 |
| 절차를 간소화하라 | 업무상 유지해야 하는 확인이 사라지지 않는가 |
| 결과가 충분히 좋다 | 후속 담당자가 사용할 기준까지 충족하는가 |
이 표는 연구에서 검증된 평가 척도가 아니라 기업 OJT를 위한 질문 예시다. 직무에 따라 용어와 판단 기준을 바꿔야 한다. 공통 원칙은 AI의 제안을 권위로 받아들이는 대신, 기준과 근거를 대조하게 하는 것이다.
학습자가 피드백을 거부했다는 사실만으로 비판적 사고가 뛰어나다고 평가하지도 않는다. 필요한 제안을 근거 없이 무시할 수 있기 때문이다. 수용했는지 거부했는지보다, 왜 그렇게 했는지를 확인해야 한다. 타당한 제안을 활용하고 부적절한 제안을 수정하는 능력이 함께 필요하다.
지도 시간이 부족할수록 개입할 장면을 정한다
AI 도구가 학습자의 모든 수행을 기록할 수 있어도 지도자가 그 기록을 전부 읽을 수는 없다. 검토 대상이 늘어난 만큼 지도 시간이 늘지 않는다면, 중요한 장면이 방대한 로그 속에 묻힐 수 있다. 무엇을 사람과 함께 검토할지 미리 정하는 것이 필요하다.
예를 들어 학습자와 도구의 판단이 크게 다르거나, 같은 오류가 반복되거나, 새로운 조건에서 수행이 흔들리는 장면을 우선할 수 있다. 결과는 맞았지만 근거를 설명하지 못한 경우도 포함한다. 반대로 형식적인 표현 수정만 필요한 사례는 별도 연습으로 다룰 수 있다.
단, 자동 경고만으로 검토 대상을 고르면 도구가 찾지 못한 오류도 함께 놓칠 수 있다. 일부 정상 판정 사례를 직접 살펴보는 절차를 남겨야 한다. 무엇을 우선 확인할지 도구가 제안하더라도, 지도자가 표본과 기준을 조정할 수 있어야 한다.
개입 시점도 과제의 성격에 따라 다르다. 연습용 과제라면 학습자가 한 번 판단한 뒤 비교하게 할 수 있지만, 실제 고객이나 설비에 영향을 주는 업무라면 정해진 확인 전에 실행하지 않도록 해야 한다. 실습에서의 시행착오와 실제 업무의 책임 범위를 섞어서는 안 된다.
교육팀은 지도 시간 자체를 업무 계획에 반영해야 한다. AI가 기본 피드백을 제공한다는 이유로 지도 시간을 모두 없애면, 남은 고난도 판단은 더 다루기 어려워진다. 줄어든 반복 설명 시간을 어떤 관찰과 토론으로 옮길지 합의하는 편이 현실적이다.
같은 점수보다 같은 기준으로 보는지가 중요하다
훈련 도구의 점수가 좋아졌다고 현장 역량을 바로 인정할 수는 없다. 연습에서 익숙해진 형식에 적응했을 수도 있고, 도구의 피드백을 잘 따르는 능력이 높아졌을 수도 있다. 실제로 맡길 업무를 판단하려면 다른 조건의 과제와 별도의 평가 근거가 필요하다.
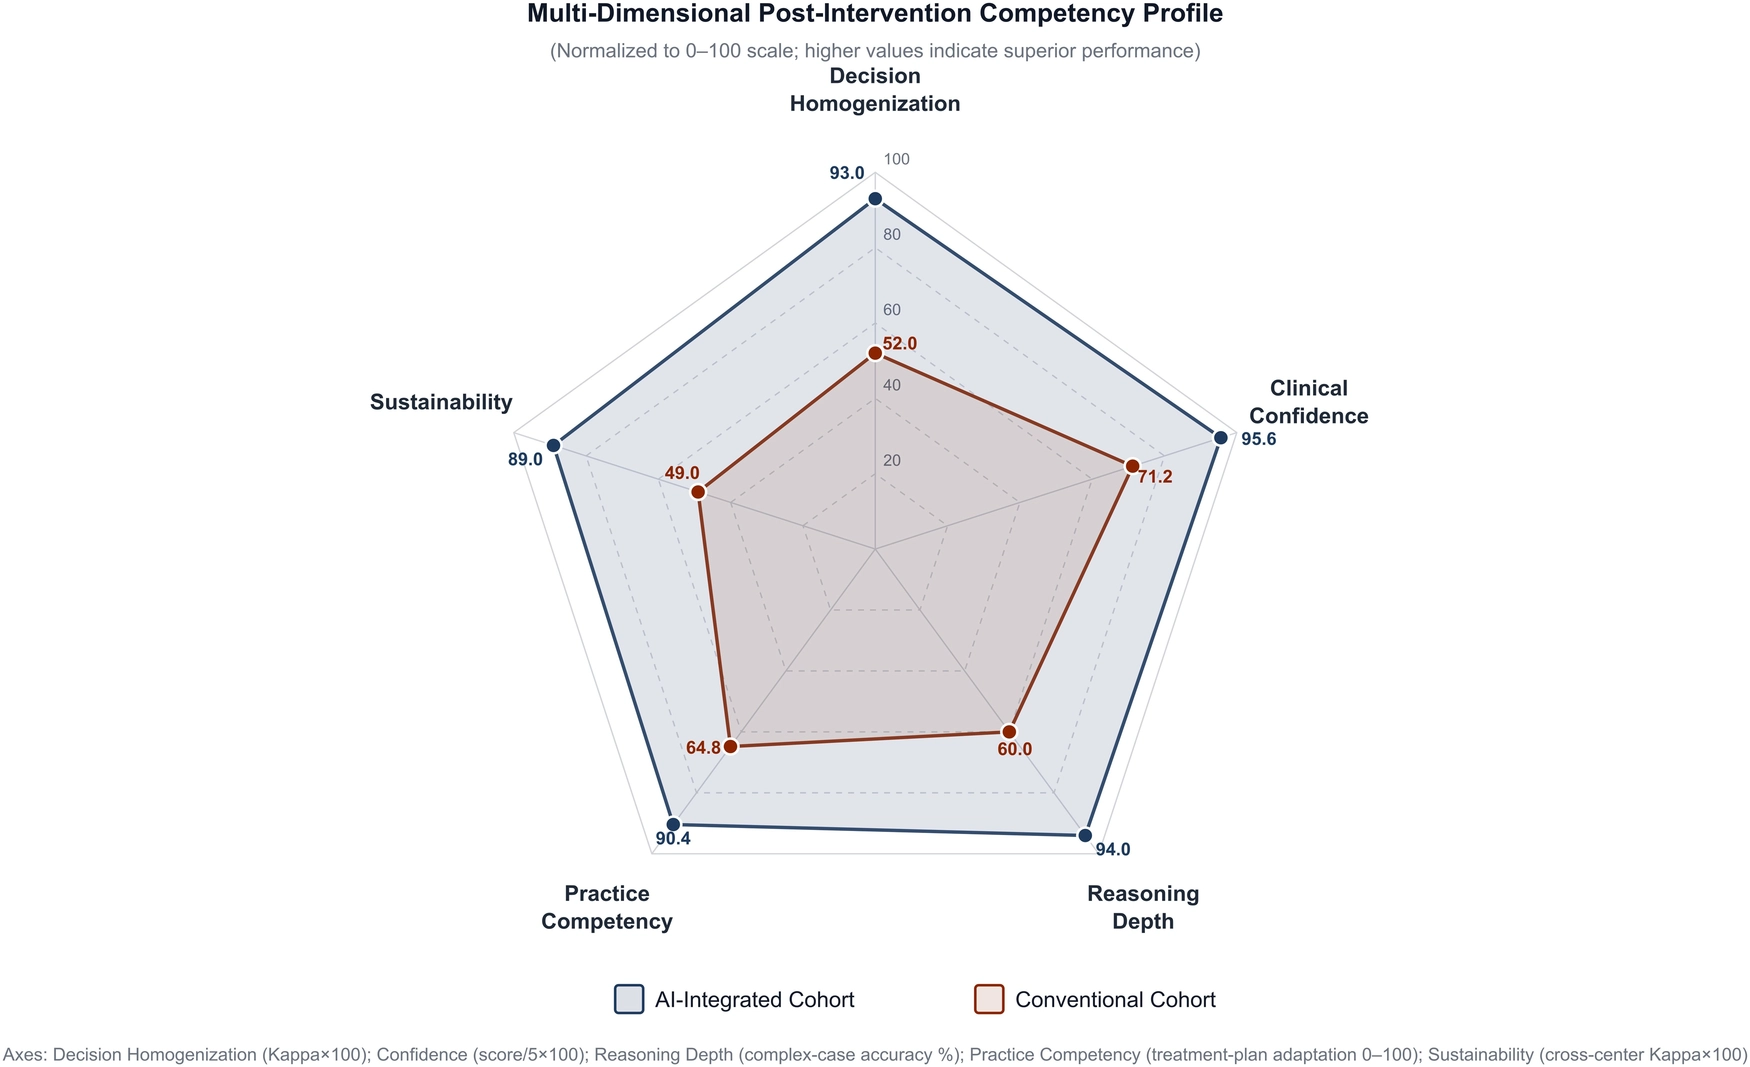
Wu·Li, Figure 3. 영역별 값을 0–100으로 정규화한 원문 도표다. 네 영역은 교육 직후, 지속성 영역은 한 달 후 측정치다. 다섯 축이 동일한 단위의 실제 업무 성과이거나 같은 시점의 관찰값인 것은 아니다.
앞서 소개한 안과 훈련 연구는 훈련 도구와 평가 체계를 분리했고, 여러 판단 영역을 구분했다. 다만 연구자들도 훈련에서 익힌 기준에 대한 친숙성이 평가에 영향을 줄 가능성을 한계로 남겼다. 기업에서도 도구 안의 점수와 독립적으로 확인한 업무 수행을 나눠 보는 이유가 여기에 있다.
기업의 평가 과제에는 연습에서 본 사례를 그대로 복제하기보다 중요한 조건을 바꾼 사례를 포함할 수 있다. 지도자는 결과의 적절성, 근거의 충분성, 추가 확인의 필요성을 함께 본다. 학습자가 설명을 잘한다는 이유로 실제 수행의 결함을 놓치지 않도록 결과물과 행동도 확인한다.
지도자끼리 같은 사례를 검토하는 시간도 필요하다. 같은 답에 서로 다른 피드백을 줬다면 개인의 취향인지 업무 기준의 차이인지 구분한다. 합의해야 할 핵심 기준과 여러 판단이 허용되는 부분을 나누면, 학습자가 지도자마다 답을 바꾸는 상황을 줄일 수 있다.
숙련자의 예외 판단을 가르칠 수 있는 형태로 남긴다
숙련자는 어떤 상황이 평소와 다른지 빠르게 알아차리지만, 그 이유를 설명하는 데는 익숙하지 않을 수 있다. AI가 표준적인 답을 빠르게 제시하는 환경에서는 이런 예외 판단이 더 중요해진다. 지도자 육성도 강의 전달 기술에만 머물러서는 안 된다.
지도자는 자신이 결과를 고친 사례를 돌아보며 어떤 단서를 봤는지, 어떤 대안을 버렸는지, 어떤 정보가 더 있었다면 결론을 바꿨을지 정리할 수 있다. 모든 경험을 일반 규칙으로 만들 필요는 없다. 특정 조건에서만 유효한 판단이라면 그 조건까지 함께 남겨야 한다.
이를 후배에게 전달할 때는 정답 설명으로 끝내지 않는다. 비슷하지만 조건이 조금 다른 사례를 제시해 같은 판단을 적용할 수 있는지 확인한다. 후배가 다른 결론을 냈다면 이유를 듣고 기준을 대조한다. 숙련자의 결론을 기억하는 것과 숙련자가 본 단서를 알아보는 것은 다르다.
기업은 이런 지도 활동을 부수적인 친절로 취급하지 말아야 한다. 현장지도자에게 필요한 시간, 검토 자료, 동료 지도자와의 논의 기회를 제공해야 한다. 업무량은 그대로 둔 채 더 정교한 지도만 요구하면 가장 경험 많은 사람에게 부담이 집중된다.
지도자의 성과도 답을 얼마나 빨리 고쳐 줬는지보다 학습자가 다음 과제에서 더 적절하게 판단했는지로 살펴야 한다. 도움 요청이 줄었다는 사실만으로 독립성을 판단하지 않는다. 필요한 상황에서 적절히 질문하는 능력도 숙련의 일부다.
지도자에게 남길 책임을 먼저 정하고 도구를 붙인다
AI 지원 OJT를 시작할 때 도구의 기능 목록보다 먼저 정할 것은 사람의 책임이다. 누가 업무 기준을 정하고, 누가 피드백의 오류를 검토하며, 누가 독립 수행의 범위를 판단할 것인가. 이 질문에 답해야 자동 피드백이 현장 지도 안에서 제 역할을 할 수 있다.
처음에는 특정 직무의 제한된 과제에서 운영할 수 있다. 학습자의 최초 판단, AI의 피드백, 사람과 검토한 이유, 다음 과제의 수행을 연결해서 살펴본다. 어떤 기록이 실제 지도에 도움이 됐고 어떤 기록은 부담만 늘렸는지 확인하며 범위를 조정한다. 이것은 도입 효과가 보장된 절차가 아니라 현장에 맞는 지도 방식을 찾아가는 운영 제안이다.
판단 과정 지도는 학습자의 모든 생각을 감시하는 일이 아니다. 업무상 필요한 근거를 설명하고, 부족한 정보를 확인하며, 수정 이유를 이해하게 하는 일이다. 기록의 목적과 사용 범위를 분명히 해야 학습자가 실패를 숨기지 않고 검토할 수 있다.
AI 시대 현장지도자의 가치는 자동 답변보다 더 많은 답변을 하는 데 있지 않다. 학습자가 그 답을 언제 받아들이고 언제 바꿔야 하는지 이해하도록 돕는 데 있다. 다음 OJT에서는 결과물을 고치기 전에 먼저 물어보자. 무엇을 보고 그렇게 판단했으며, 어떤 조건이 달라지면 결론을 바꾸겠는가.
함께 읽을 글
- AI 활용사례 공유회, 멋진 시연보다 다시 해볼 조건을 남겨라
- 전문서비스 AI 도제학습에서 주니어가 AI에게 배울 수 없는 것
- 사내강사 AI 역할 분담: 자동화보다 강사 주도 팀 설계
출처
- Zhipeng Wu, Long Li. Effect of AI-driven simulation integrated with virtual case-based training on diagnostic and therapeutic reasoning homogenization among junior ophthalmologists: a prospective cohort study. Frontiers in Medicine 13, 1812146, 2026-09-18. 원문. 단일 기관·비무작위 코호트·교육 후 한 달 추적. 기업교육 효과로 일반화하지 않음.
- Heather Stringer. How chatbots are enhancing, not replacing, clinician training. American Psychological Association, Monitor on Psychology 57(6), 2026-09-01. 원문. 임상 훈련 전문가 인터뷰 기사. 지도자의 AI 피드백 검토 역할 관련, 독립적인 기업교육 실험이 아님.