교육 성과 보고서를 펼쳐 다음 세 가지부터 확인해 보자.
- 교육을 마친 사람과 사후 평가에 응답한 사람의 수가 따로 적혀 있는가.
- 교육 전후의 점수가 같은 사람에게서 나온 것인지 확인할 수 있는가.
- 응답하지 않은 사람의 결과가 다르다고 가정해도 지금의 운영 결정을 유지할 수 있는가.
답하기 어렵다면 평균 점수를 해석하기 전에 평가에 남은 사람이 누구인지부터 확인해야 한다. 교육이 효과가 없다는 뜻은 아니다. 관찰한 사람의 변화와 전체 대상자의 변화를 아직 구분하지 못했다는 뜻이다. 좋은 결과를 보고한 뒤에야 한계 문구를 붙이기보다, 보고서가 설명할 수 있는 사람의 범위를 처음부터 정하는 편이 낫다.
교육 추적조사는 과정이 끝난 뒤 학습과 업무 적용의 변화를 정해 둔 시점에 확인하는 절차다. 이때 탈락·무응답 편향은 평가에 남은 사람과 빠진 사람의 차이 때문에 결론이 치우치는 문제를 가리킨다. 자료가 일부 빠졌다는 이유만으로 편향이 반드시 생기는 것은 아니다. 중요한 것은 누가 왜 빠졌는지, 그 이유가 평가하려는 결과와 연결되는지다.
기업교육 담당자가 해야 할 일도 무응답자의 점수를 알아맞히는 것이 아니다. 무엇이 관측됐고 무엇이 아직 확인되지 않았는지 설명한 뒤, 가능한 가정에 따라 결론이 얼마나 달라지는지 판단해야 한다. 최근의 직원교육 사례와 결측 자료 방법론을 함께 보면 이 경계가 선명해진다. 다음의 운영 방식은 해당 연구에서 효과를 검증한 패키지가 아니라 기업교육 평가에 적용하기 위한 제안이다.
수료자와 사후 설문 응답자는 같은 분모가 아니다
수료율이 높아도 평가 자료가 모두 모이는 것은 아니다. 2026년 9월 발표된 Gakyoung Baek 외의 병원 직원 AI 교육 연구에서는 등록한 83명이 모두 교육을 마치고 사전 설문에 응답했다. 그러나 사후 응답은 64명으로 77.1%였다. 나머지 19명, 22.9%는 교육 중도이탈자가 아니라 사후 설문 미응답자다. 이 차이를 지우면 운영상의 완료와 평가 자료의 확보를 혼동하게 된다.[1]
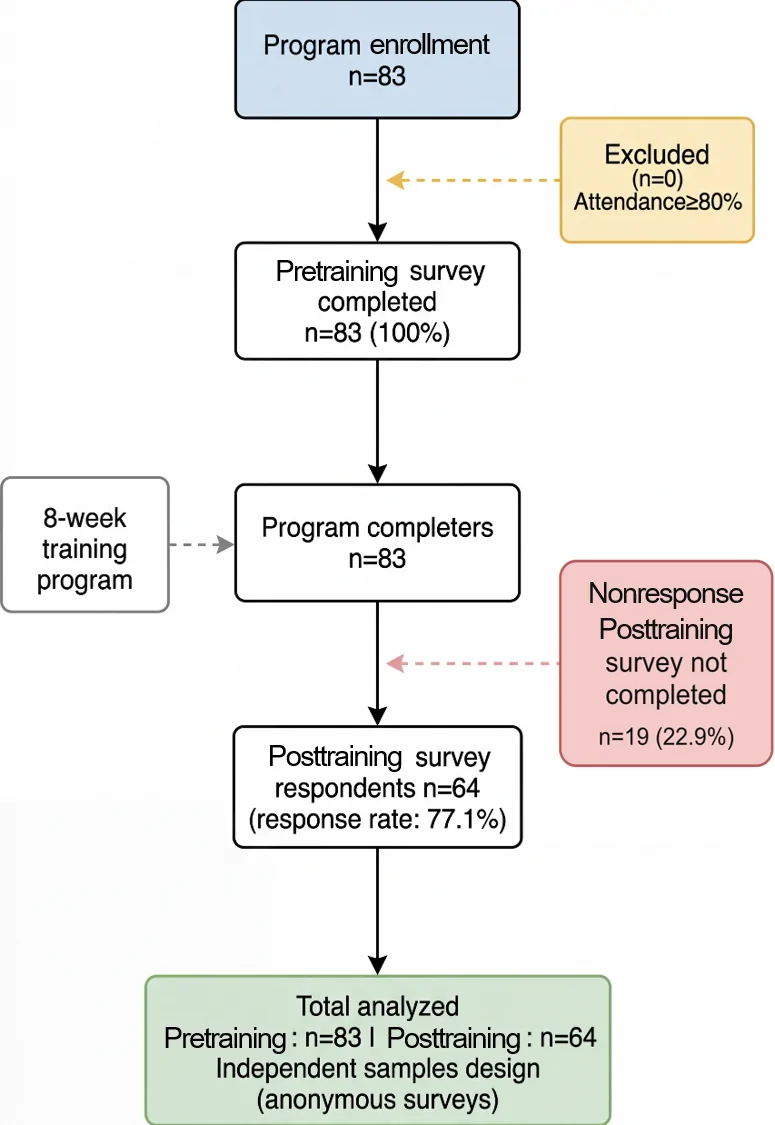
Teaching Model Context Protocol, Retrieval-Augmented Generation, and AI Agents to a Multidisciplinary Hospital Workforce: Single-Group Pre-Post Survey Study, Figure 1, Participant flow diagram. 원문 발췌. 원본; CC BY 4.0.
그림 1. 등록·교육 수료·사전 응답 83명과 사후 응답 64명을 구분한 원문 흐름도. 19명의 사후 무응답을 교육 중도이탈로 해석하지 않는다. 익명 설문이어서 전후 자료는 독립표본으로 분석했다. 출처: Baek 외, 2026, Figure 1. 원본 이미지 형식만 PNG로 변환, 내부 미번역.
이 연구는 서울아산병원을 중심으로 실시한 직원교육 사례다. 익명 설문 때문에 개인별 전후 응답을 연결할 수 없었고 비교집단도 없었다. 따라서 전후 집단 평균의 차이를 같은 사람의 향상이나 교육만의 인과효과로 바꾸어 읽어서는 안 된다. 국내 병원의 특정 교육 결과를 전체 기업교육의 일반적인 효과로 확대할 근거도 없다. 여기서 실무자가 참고할 지점은 성과 숫자보다 수료와 응답의 흐름을 따로 공개한 방식이다.
우리 회사의 평가에서도 먼저 흐름을 나눠야 한다. 등록했지만 시작하지 않은 사람, 시작했지만 수료하지 않은 사람, 수료했지만 평가에 응답하지 않은 사람은 다른 지원이 필요하다. 설문 전체를 제출했어도 중요한 문항을 비워 뒀다면 그 지표에는 결측이 남는다. 여러 시점의 응답은 있는데 개인을 연결할 수 없다면 그것도 별도의 분석 제약이다. 이들을 모두 ’평가 미완료’로 묶으면 다음 과정에서 무엇을 고칠지 알 수 없다.
분모는 보고하려는 주장에 맞춰 적는다. 수료자 경험을 알고 싶다면 수료자 가운데 응답한 비율이 필요하고, 최초 교육 대상자 전체의 변화를 말하려면 처음 정한 대상 집단을 끝까지 추적해야 한다. 과정 중에 전보·휴직·직무 변경이 생겼다고 명단에서 조용히 빼서는 안 된다. 제외가 타당한지 먼저 정한 기준으로 검토하고 원래 대상자 기준과 현재 적용 가능자 기준이 어떻게 달라지는지 남긴다.
익명조사를 곧바로 잘못된 설계로 판단할 필요는 없다. 익명성이 필요한 질문도 있고 개인 변화보다 집단의 경험을 확인하는 조사도 있다. 다만 개인별 변화가 의사결정에 꼭 필요하다면 조사 전에 연결 방식을 준비해야 한다. 응답 내용의 열람 권한과 연결용 정보의 보관 범위를 따로 정하고 조사 목적을 설명한다. 나중에 평균 차이를 발견한 뒤 개인별 효과처럼 해석하는 것이 문제다.
작은 결측도 여러 항목을 합치면 커질 수 있다
교육 전이 점수에 필요한 응답은 있는데 업무 적용 기록이 없거나, 관리자 확인은 있는데 사전 점수가 없는 경우가 있다. 각 자료의 확보율만 보면 높아 보여도 모든 항목을 동시에 가진 사람은 훨씬 적을 수 있다. 종합지표를 만들기 전에 그 지표의 계산에 어떤 자료가 함께 필요한지 확인해야 하는 이유다.
이 문제는 기업교육에만 나타나는 현상이 아니다. Jiunn Wang·Baptiste Leurent·Manuel Gomes가 2026년 8월 발표한 검토는 2022~2024년 영국 임상시험 기반 비용효과분석 63편을 다뤘다. 완전한 비용·효과 자료를 가진 참가자 비율의 연구별 중앙값은 61%였다. 여러 구성 항목의 일부 결측이 전체 지표의 완전 자료 비율을 낮출 수 있다는 설명은 교육평가에서도 참고할 방법론적 문제다. 이 61%를 기업교육 응답률로 옮겨 쓰지는 않는다.[2]
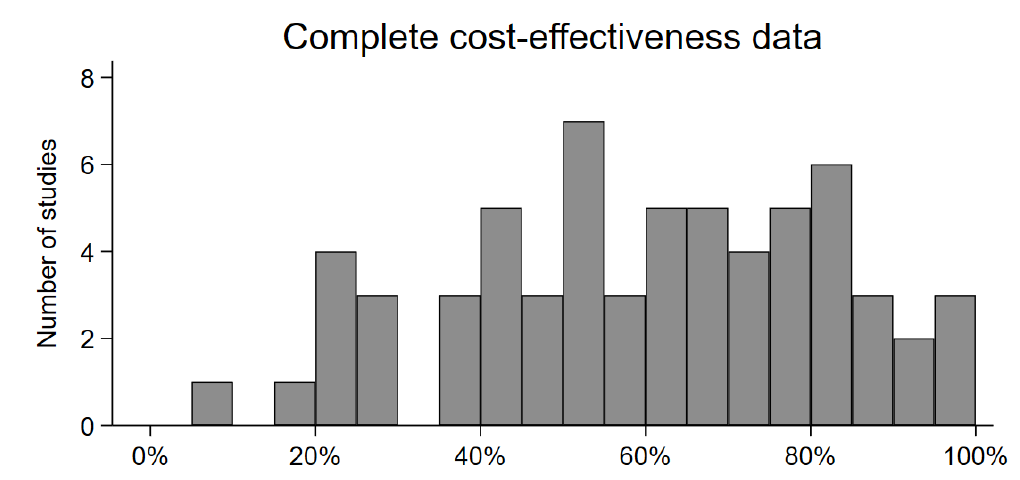
Missing Data in Trial-Based Cost-Effectiveness Analysis: The Journey Continues, Author accepted manuscript p. 8 / Figure 2 top panel. 원문 발췌. 원본; CC BY.
그림 2. Figure 2의 최상단 패널. 가로축은 비용·효과 자료가 모두 갖춰진 참가자의 비율, 세로축은 해당 구간의 연구 수다. 기업교육 조사 결과가 아니라 결측 자료 문제를 다룬 방법론 참고 자료다. 출처: Wang·Leurent·Gomes, 2026, 공개 저자 수락본 p.8. 상단 패널 발췌, 내부 미번역.
실무에서는 지표마다 실제 분석에 들어간 사람 수를 표시한다. 지식 점수, 업무 적용 여부, 관리자 관찰, 성과 자료가 서로 다른 사람에게서 나왔다면 동일한 집단을 설명하는 숫자처럼 붙이지 않는다. 사전·사후·추적 시점까지 모두 있어야 계산되는 지표라면 각 단계에서 얼마나 남는지 확인한다. 자료를 많이 수집하는 것과 분석에 사용할 수 있는 자료를 확보하는 것은 다르다.
모든 항목이 있는 사람만 분석하는 방법을 무조건 금지할 수는 없다. 문제는 그 선택을 설명하지 않고 기본값으로 쓰는 것이다. 빠진 자료의 이유와 분석 목적에 따라 적합한 방법이 달라진다. 부분적으로 있는 정보까지 버리는 데 따른 손실도 검토해야 한다. 이 판단은 교육담당자의 임의 규칙보다 분석 담당자와 함께 정한 가정과 절차를 따라야 한다.
결측을 줄이겠다는 이유로 설문을 늘리는 것도 해법은 아니다. 핵심 질문이 많아질수록 응답 부담과 자료 연결의 복잡성이 함께 커질 수 있다. 먼저 운영 결정을 바꿀 지표가 무엇인지 정하고 그 지표를 계산하는 데 필요한 자료를 우선 확보한다. 있으면 흥미로운 문항과 없으면 결론을 내릴 수 없는 문항을 구별하면 추적조사의 목적도 선명해진다.
응답률이 비슷해도 무응답 편향이 없다고 단정할 수 없다
두 사업장의 응답률이 같아도 빠진 사람의 구성이 다를 수 있다. 한쪽은 업무가 바빠 적용 기회가 많은 사람이 응답하지 않았고, 다른 쪽은 내용을 이해하기 어려웠던 사람이 응답하지 않았다고 가정해 보자. 빠진 비율은 같지만 결과 해석에 미치는 방향은 다를 수 있다. 이 예시는 실제 관측 결과가 아니라 응답률 하나로 대표성을 판단할 수 없는 이유를 설명한다.
확인할 수 있는 차이부터 본다. 응답자와 미응답자의 직무, 근무 형태, 사전 점수, 참여 정도 등 이미 적절한 목적으로 확보한 정보를 비교한다. 다만 차이가 통계적으로 뚜렷하지 않다는 이유만으로 ’문제없음’을 선언하지 않는다. 표본이 작아 차이를 발견하기 어려울 수 있고 관측하지 못한 이유가 남아 있을 수 있다. 관측 자료의 비교는 설명을 보강하는 단서이지 보이지 않는 결과까지 확인하는 절차가 아니다.
누락 사유는 학습자의 태도 평가가 아니라 다음 조치를 위한 정보로 기록한다. ‘관심 없음’ 같은 추정 대신 연락이 닿지 않음, 응답 시간이 맞지 않음, 문항의 적용 대상이 아님, 답변을 원하지 않음처럼 확인된 사실을 구분한다. 원인을 모르면 미확인으로 남긴다. 관리자가 바빴을 것이라고 짐작한 내용을 학습자의 실제 답변처럼 저장해서는 안 된다.
| 평가에서 발견한 공백 | 먼저 확인할 내용 | 바로 해서는 안 되는 해석 |
|---|---|---|
| 수료 뒤 설문 전체가 없음 | 응답 가능 여부와 미응답 사유를 확인할 경로 | 교육 효과가 없었을 것이라고 단정 |
| 특정 문항만 비어 있음 | 해당 업무의 적용 대상인지, 질문을 이해했는지 | 빈칸을 일괄 0점으로 처리 |
| 사전·사후 응답 연결이 안 됨 | 연결키의 존재와 조사 때 안내한 사용 범위 | 전후 집단 차이를 개인 향상으로 표시 |
| 적용 행동의 관측이 없음 | 실제로 업무 기회가 있었는지 | 기회가 없었던 사람을 수행 실패로 분류 |
특히 ’해당 없음’과 무응답은 따로 설계해야 한다. 교육 뒤 해당 업무를 맡지 않은 사람에게 적용 빈도를 묻고 빈칸을 받았다면, 설문 구조가 구분했어야 할 상태를 놓친 셈이다. 적용 기회가 없는 사람의 역량을 자동으로 낮게 평가할 수는 없다. 반대로 기회가 없었던 사람을 모두 제외하고 현업 전이가 높다고 발표하면 조직이 실제로 제공한 적용 기회가 보이지 않는다. 기회와 수행을 함께 보고하되 다른 지표로 유지한다.
미응답자를 0점으로 채우는 대신 가정을 바꿔 본다
결측 처리에서 가장 쉬운 선택은 빈칸에 하나의 값을 넣는 것이다. 미응답자를 실패로 간주하거나 응답자 평균을 그대로 넣으면 계산은 끝나지만 확인하지 않은 결과를 아는 것처럼 만들 위험이 있다. 여러 값을 대입하는 민감도 분석도 그 자체로 실제 점수를 복원하는 기술은 아니다. 가정이 달라질 때 결론과 의사결정이 얼마나 흔들리는지 확인하는 과정이다.
다음은 계산 원리를 설명하기 위한 가상 예시다. 교육 대상 100명 중 70명에게서 개인별 전후 자료를 확보했고 이들의 평균 점수 변화가 +10점이라고 하자. 나머지 30명의 평균 변화는 모른다. 점수 척도상 아래 변화가 모두 가능한 상황이라고 가정하면, 미관측 집단에 두는 값에 따라 전체 평균 변화는 다음처럼 달라진다. 이는 실제 회사의 조사 결과가 아니다.
| 미응답 30명의 평균 변화에 둔 가정 | 전체 100명의 평균 변화에 대한 계산 |
|---|---|
| 응답자와 같은 +10점 | (70×10 + 30×10)÷100 = +10점 |
| 변화 없음, 0점 | (70×10 + 30×0)÷100 = +7점 |
| 평균 -10점 | (70×10 + 30×-10)÷100 = +4점 |
여기서 +4점을 실제 하한이라고 부를 수는 없다. 가능한 모든 조건을 검토한 것이 아니기 때문이다. +7점이 가장 합리적인 추정이라고 말할 근거도 아직 없다. 어떤 가정이 업무 상황에서 타당한지 검토하고 사전 점수와 직무 등 관측된 정보를 어떻게 반영할지는 분석 담당자가 판단해야 한다. 이 표의 목적은 응답자 평균을 전체에 적용할 때 이미 하나의 가정을 하고 있다는 사실을 드러내는 데 있다.
운영 결정과 연결하면 질문이 달라진다. 여러 합리적인 가정에서도 과정의 보완이 필요하다면 보완을 진행할 근거가 더 분명해진다. 반면 확대 여부가 가정 하나에 따라 뒤집힌다면 확정적인 성공 선언보다 추가 자료 확보가 우선이다. 결과표에는 보기 좋은 하나의 평균만 남기지 말고 어떤 가정에서 어느 판단이 달라지는지 보여 준다. 변화량 자체도 교육의 인과효과와 같지는 않다는 구분을 유지한다.
통계 소프트웨어의 자동 보완 기능을 쓰더라도 가정은 사라지지 않는다. 관측한 정보로 빠진 이유를 충분히 설명할 수 있는지, 관측하지 못한 성과와 미응답이 연결될 가능성이 있는지를 검토해야 한다. 방법의 이름만 적는 것으로는 부족하다. 왜 그 방법을 선택했는지와 다른 가정에 따른 결과를 남겨야 다음 담당자가 분석을 이어받을 수 있다. 교육팀이 임의로 복잡한 추정 모델을 구현할 필요는 없지만 어떤 질문을 분석 담당자에게 맡겼는지는 설명할 수 있어야 한다.
재연락은 응답률보다 빠진 이유를 확인하도록 설계한다
추적조사는 종료 후 설문을 다시 보내는 일로 끝나지 않는다. 과정 설계 때부터 언제 업무 적용 기회가 생기는지, 누구에게 어떤 방식으로 연락할 수 있는지 정해야 한다. 응답을 받는 시점이 직무별 적용 기회와 맞지 않으면 같은 문항으로도 다른 상태를 측정하게 된다. 담당자가 바뀌거나 대상자가 이동했을 때 연락과 기록을 이어받을 책임도 필요하다.
첫 재연락은 전체 설문을 그대로 반복하기보다 응답을 막는 조건을 확인하는 데 쓸 수 있다. 연결 문제인지, 시간이 필요한지, 업무 기회가 없었는지, 질문에 답하기 어려운지를 짧게 파악한다. 답변을 원하지 않는 선택도 구별해 남긴다. 재연락에서 얻은 짧은 답변은 원래의 평가점수와 같은 자료가 아니므로, 전체 설문 응답과 섞어 평균을 내지 않는다.
관리자는 연락을 돕고 적용 기회를 확인할 수 있지만 부하직원의 응답을 대신 작성해서는 안 된다. 응답률을 부서 실적으로 압박하면 평가의 목적과 응답의 자발성이 충돌할 수 있다. 조사 결과를 어떤 결정에 쓰고 누가 볼 것인지 미리 안내한다. 작은 집단의 결과를 공유할 때는 개인이 드러나는 방식으로 미응답자를 지목하지 않는다. 이는 특정 법규를 설명하는 문장이 아니라 평가 운영에서 정할 기본 조건이다.
교육팀은 대상자 흐름과 연락 기록을 관리하고, 현업은 업무 적용 기회를 확인하며, 분석 담당자는 결측 가정과 추정 범위를 검토하도록 역할을 나눌 수 있다. 어느 한쪽이 자료의 빈칸을 임의로 메우지 않게 하는 분담이다. 분석이 끝난 뒤에는 미응답자를 더 많이 붙잡는 데만 집중하지 말고 핵심 문항을 줄이거나 조사 시점을 바꾸거나 적용 기회를 확보하는 등 다음 과정에서 줄일 수 있는 공백을 찾는다.
성과 보고서 첫 화면에 관찰 범위를 함께 적는다
보고의 첫 화면에는 결과와 함께 대상 범위를 제시한다. 최초 대상자, 실제 참여자, 수료자, 해당 지표의 응답자와 분석 인원, 전후 연결 가능 여부가 보여야 한다. 모든 인원을 한 줄에 억지로 넣을 필요는 없지만 독자가 평균의 분모를 찾으러 부록까지 내려가게 해서는 안 된다. 보고서의 제목도 ’전체 직원의 역량 향상’과 ’응답자에게서 관찰한 점수 변화’를 구별해야 한다.
핵심 한계는 추상적인 ’일부 한계가 있음’으로 끝내지 않는다. 어느 집단의 자료가 더 적은지, 어떤 결과를 아직 알 수 없는지, 가정이 바뀌면 어떤 결정이 달라지는지를 적는다. 담당자가 할 수 있는 다음 조치도 붙인다. 추가 연락이 필요한지, 업무 기회를 먼저 제공해야 하는지, 분석 방법을 검토해야 하는지에 따라 책임자가 달라진다. 불확실성을 적는 일은 보고를 약하게 만드는 일이 아니라 다음 판단의 조건을 명확히 하는 일이다.
교육 추적조사의 신뢰는 응답률 하나로 결정되지 않는다. 높은 응답률이라도 일부 직무가 계속 빠지면 그 직무의 결과를 설명하기 어렵고, 낮은 응답률이라도 관찰 범위와 가정이 분명하면 제한된 운영 결정을 지원할 수 있다. 필요한 것은 무응답자를 성공이나 실패로 채우는 습관을 멈추고 보이는 변화와 아직 확인하지 못한 변화를 함께 다루는 일이다. 평균을 보고하기 전에 그 평균 밖에 남은 사람이 누구인지부터 확인해야 한다.
함께 읽을 글
출처
- Gakyoung Baek, Hyunna Lee, Dong Hyun Yang, Minseo Kang, Kun Hee Lee, Minji Choi, Yura Lee, Kye Hwa Lee. Teaching Model Context Protocol, Retrieval-Augmented Generation, and AI Agents to a Multidisciplinary Hospital Workforce: Single-Group Pre-Post Survey Study. JMIR Medical Education 2026; 12: e97822, 2026-09-11. 원문, PMC 공개 원문. DOI: 10.2196/97822. 국내 병원 직원 교육의 수료·응답 구분 사례이며 일반적인 기업교육 효과율로 해석하지 않았다.
- Jiunn Wang, Baptiste Leurent, Manuel Gomes. Missing Data in Trial-Based Cost-Effectiveness Analysis: The Journey Continues. PharmacoEconomics, 2026-08-12. 출판사, UCL 공개 저자 수락본. 기업교육 실태 자료가 아니라 결측을 다루는 방법론적 참고로 사용했다.